Monday, 3 November 2014
Virtual reality bakal
kembali dalam cara yang sangat menakjubkan dengan kehadiran Oculus Rift,
perangkat yang diperkenalkan di Consumer Electronics Show, Las Vegas, Nevada. Oculus Rift adalah Head-mounted Virtual Reality Display (sebuah display yang langsung dikenakan didepan mata), yang dalam bahasa Indonesia dapat ditranslasikan sebagai layar virtual reality yang dipasang di kepala. Oculus Rift dilengkapi dengan head tracking, yg akan mengikuti pergerakan kepala kita. Pandangan kita dalam game menyesuaikan dengan pergerakan kepala kita, menunduk/menoleh dan menengadah. Virtual reality adalah simulasi keberadaan fisik suatu tempat dan objek yang dilakukan oleh komputer. Secara sederhana, Oculus Rift adalah sebuah layar komputer berbentuk kacamata yang ditempelkan di kepala dengan tali elastis. Masing-masing mata melihat pada layarnya tersendiri, dan menghalangi semua pandangan selain pada layar. Gambar yang ditampilkan tidaklah sama persis, layar kiri menunjukkan lebih banyak area di sebelah kiri dan sebaliknya untuk yang kanan. Saat menggunakan alat ini, otak anda menangkap kedua gambar dan menyatukannya menjadi sebuah gambar yang mensimulasikan jarak pandang mata bagaikan melihat sebuah benda di dunia nyata.

Oculus Rift juga dapat melacak pergerakan kepala, yang memungkinkan anda untuk menoleh dan melihat sekeliling di dalam game. Alat ini mendeteksi apakah anda melihat ke atas, bawah, kiri, kanan, dan juga ketika anda memiringkan kepala ke kanan atau kiri dan menyesuaikan tampilan pada layar. Hal ini dapat dilakukan menggunakan kombinasi dengan kombinasi 3 poros Gyroscope, Accelerometer, dan Magnetometer.
Oculus Rift tampak seperti sepasang kacamata ski. Di dalamnya
terdapat dua lensa, satu untuk setiap mata, yang mengarah pada layar LCD
tunggal. Layar akhir akan menjadi 7 inci, sedang prototipe yang diuji 5,6 inci.
Layar itu memberikan dua gambar terpisah, satu untuk masing-masing mata, sehingga
pengguna mendapatkan stereoscopic 3-D. Occulus Rift versi developer kit memiliki resolusi "HD" sebesar 1280 x 800 atau 640 x 800 per mata. Nantinya, di versi final, resolusi tersebut bakal ditingkatkan menjadi 1920 x 1080 yang berarti menambah beban.

Inilah yang menakjubkan,
yakni sensor di accelerometer dangyroscope yang masuk ke dalam game PC. Ketika pengguna memutar kepala,
pandangannya bergerak hampir sempurna dengan alat ini, 360 derajat, serta
pandangan ke atas dan ke bawah. Situs Oculus mengatakan Rift menggunakan teknologi pelacakan khusus yang
membuat latency pelacakan kepala 360 derajat sangat
rendah sehingga memungkinkan pengguna secara mulus melewati dunia maya seperti
di kehidupan nyata. Setiap gerakan halus kepala pengguna dilacak secara real time sehingga menciptakan pengalaman alami
dan intuitif.
Perangkat canggih
ini bekerja seperti sebuah peripheral. Anda menghubungkan ke komputer Anda dan bermain game PC dengannya. Ia membutuhkan sebuah
PC gaming berkemampuan besar pada saat ini.
Oculus Rift dimulai sebagai proyek hobi Palmer Luckey. Pria ini mengawali
idenya dengan membongkar smartphone dan lantas membuatnya sebagai
pendahulu Oculus Rift. Kemudian
proyek itu digarap Kickstarter, sebuah platform pendanaan terbesar di dunia untuk
proyek-proyek kreatif yang kabarnya telah dipatenkan oleh Facebook.

Pengguna yang
memakai Oculus Rift akan masuk ke dunia yang sama sekali baru. Gerakan tubuh mereka
bakal merespons seperti di dunia nyata. Sangat nyaman dan alatnya tidak terlalu
berat, hanya 369 gram. Benar-benar seperti kacamata ski. Rift menyediakan sudut
pandang sekitar 110 derajat. Kombinasi sudut pandang lebar dengan pelacakan
kepala dan stereoscopic 3D inilah yang diklaim pengembangnya
menciptakan pengalaman virtual reality masa depan.
Satu-satunya
masalah adalah kecenderungan untuk memindahkan seluruh
tubuhnya dan bukan hanya headset. Jika Anda bersandar untuk melihat sekitar sudut, misalnya, headset tidak dapat menerjemahkannya ke dalam
gerakan dalam game.
Development Kit
diharapkan keluar bulan Maret dan perusahaan berharap versi consumer product dapat dirilis tidak terlalu lama pada
tahun ini. Oculus mengatakan harganya sekitar US$ 300. Ini adalah pergerakan
paling inovatif pada dunia Game saat ini.


Kelebihan dan Kekurangan Oculus Rift:
Kelebihan dalam menggunakan alat ini,diantaranya
- kualitas grafis terbaik
- Pengguna serasa masuk kedalam game tersebut
- Memperluas bidang pandang game
- Kontrol dapat dilakukan lewat gerakan kepala sehingga memberi kesan nyata

Sebagai alat ciptaan menusia terutama baru
saja dikembangkan maka oculus rift tak lepas dari ketidak sempurnaan. Berikut
kekurangan dari penggunaan alat oculus rift
- Sebaiknya tidak diperbolehkan untuk usia lanjut, penyandang penyakit jantung, vertigo, ayan, hipertensi, dll karena efek dari bermain game pada Oculus Rift dapat membuat reaksi berlebihan seperti shock, kaget, takut, mual, dll.
- Game yang didukung pada Oculus Rift masih sedikit dan harga satuan gamenya cukup mahal karena pengembangannya juga masih baru.
- Penyebaran alat belum merata diseluruh dunia
- Harga cenderung mahal
- Pengguna tidak peka dengan lingkungan sekitar sehingga ia tak akan menyadari suatu kejadian darurat disekitarnya
- Mempercepat kerusakan mata karena jarak pandang mata terlalu dekat
- Pengguna akan mengalami krisis interaksi sosial

Masa Depan Oculus Rift
Selain perkembangannya dalam dunia gaming, saya rasa Oculus Rift dapat digunakan dalam berbagai macam kegunaan lain. Simulator misalnya, alat latihan yang tersedia selama ini menggunakan layar dapat digantikan dengan Oculus Rift untuk mendapatkan immersion lebih dalam. Kegunaan virtual reality tidak terhenti di sini, pengembang masih dapat menggunakannya untuk berbagai hal lain baik entertainment atau bisnis. Selain itu cara kerja
Oculus rift ini dapat dikembangkan dan diaplikasikan dalam pengoperasian alat
jarak jauh seperti kontrol pesawat tempur tak berawak, kontrol robot dan yang
lainnya.
Sunday, 2 November 2014
Siri adalah asisten pribadi
pintar yang menolong Anda menyelesaikan segala sesuatu cukup dengan meminta. Dengan
fitur yang di ciptakan oleh Apple ini, Siri memberi kemudahan yang unik kepada
para penggunanya dalam mencari informasi yang di perlukan. Siri akan membantu
dalam setiap pekerjaan Anda, Anda hanya cukup mengatakan perintah ke pada siri
dan aplikasi ini akan memahami apa yang anda perintahkan, seperti memiliki
asisten pribadi, ada beberapa hal yang bisa dilakukan oleh siri. Siri
memungkinkan Anda menggunakan suara Anda untuk mengirim pesan, jadwal
pertemuan, melakukan panggilan telepon, dan lainnya. Tetapi Siri tidak seperti
perangkat lunak pengenalan suara konvensional yang mengharuskan Anda untuk
mengingat kata kunci dan menyebutkan perintah tertentu. Siri mengerti suara
natural Anda, dan Siri menanyakan sesuatu jika memerlukan informasi lebih
lanjut untuk menyelesaikan tugas.

Hanya dengan member input suara
dalam berbahasa Inggris (maupun berbagai bahasa lain yang didukung) Siri akan
mengerti apa yang Anda katakan dan mencari informasi yang Anda perlukan,
setelah informasi didapat maka Siri akan menjawabmu. Ini seperti Anda sedang
melakukan pembicaraan dengan iphone Anda sendiri. Dengan teknologi Siri
Anda bisa menggunakan iPhone 4S dengan menggunakan perintah suara. Sebagai
contoh, saat Anda akan menelepon sang Adik, Anda tidak perlu susah-susah mencari-cari
nomor teleponnya di phonebook, tapi cukup katanya “Call My Sister” maka Siri
pun akan langsung menelpon Adik Anda.
Apilkasi Siri melakukan
banyak perintah yang bisa diberikan kepadanya, misalnya Anda bisa mengirim
email, menyuruh Siri untuk menyebutkan nomor handphone seseorang yang ada di
Phonebook, mengirimkan SMS, menyuruh Siri untuk memutar Playlist lagu, meminta
informasi tentang sesuatu misal tentang restaurant terdekat,
perintah menset alarm, perintah untuk menunjukkan arah, sampai mengatur jadwal
meeting.

Anda bisa meminta Siri untuk
mengirim sms ke seseorang, mengingatkan akan berbagai hal, atau mencari
direction, dan siri juga bisa mencari tahu aplikasi apa yang akan di gunakan.
Siri mencari jawaban untuk anda via website terutama dari Yelp and Wolfram
Alpha. Siri juga menggunakan servise lokasi, Siri juga mengingat dimana tempat
tinggalmu, dimana Anda bekerja, dan dimana Anda berada.
Sehinga siri dapat memberikanmu informasi dan pilihan yang terbaik. Dari kontak Anda, siri juga mengetahui siapa temanmu, keluargamu, pacarmu dan bosmu jadi Anda dapat memberikan perintah kepada siri untuk mengirim sms kepada pacar atau orangtuamu contohnya : kirim sms ke Pacar “saya nanti agak telat menjemputmu” atau telepon taxi sekarang! dan bangyak lagi kegunaan dari siri.Sangat mudah dan cepat bukan?
Sehinga siri dapat memberikanmu informasi dan pilihan yang terbaik. Dari kontak Anda, siri juga mengetahui siapa temanmu, keluargamu, pacarmu dan bosmu jadi Anda dapat memberikan perintah kepada siri untuk mengirim sms kepada pacar atau orangtuamu contohnya : kirim sms ke Pacar “saya nanti agak telat menjemputmu” atau telepon taxi sekarang! dan bangyak lagi kegunaan dari siri.Sangat mudah dan cepat bukan?

Siri tersedia di perangkat berikut:
- iPhone 4s atau versi lebih baru
- iPad generasi ke-3 atau versi lebih baru
- iPad mini
- iPod touch (generasi ke-5)
Dengan
app apa Siri dapat berfungsi?
Siri berfungsi dengan hampir semua app internal. Dan Siri cukup
pintar untuk menentukan app yang digunakan untuk memberikan jawaban. Siri juga
menggunakan Layanan Pencarian dan Lokasi untuk membantu memenuhi permintaan
Anda. Berikut adalah daftar app dan layanan yang berfungsi dengan Siri di
seluruh dunia:

- Telepon
- FaceTime
- Dikte
- Musik
- Pesan
- Kalender
- Pengingat
- Catatan
- Kontak
- Alarm
- Jam Dunia
- Timer
- Cuaca
- Shazam
- Saham
- Pencarian Web
- Pencarian Wikipedia
- Wolfram|Alpha (Hanya bahasa Inggris)
- Cari Teman Saya
- Posting di Facebook atau Twitter
- Film
- Olahraga
- Peluncuran app
- Peta
- Pencarian lokal
Siri mengerti dan dapat berbicara dalam bahasa berikut:

- Amerika Serikat (Inggris, Spanyol)
- Inggris (Inggris)
- Australia (Inggris)
- Prancis (Prancis)
- Jerman (Jerman)
- Jepang (Jepang)
- Kanada (Prancis Kanada, Inggris)
- Cina (Mandarin)
- Hong Kong (Kanton)
- Italia (Italia)
- Korea (Korea)
- Meksiko (Spanyol)
- Spanyol (Spanyol)
- Swiss (Prancis, Jerman, Italia)
- Taiwan (Mandarin)
Bagaimana
SIRI dapat bekerja?
SIRI diprediksi terdiri dari 3
lapis program: analiser ucapan ke teks, analiser tata bahasa, dan beberapa
penyedia layanan.
- Analiser ucapan ke teks (speech to text analyzer) adalah software yang berfungsi untuk mengubah suara yang masuk menjadi teks. Kendati secara konsep sederhana, namun tidak demikian dengan implementasinya. Ketepatan dalam mengkonversi sebuah ucapan ke dalam sebuah teks memerlukan algoritma yang sangat rumit yang dikembangkan selama bertahun-tahun. Di SIRI, pekerjaan ini telah disederhanakan karena SIRI tidak diharuskan mengkonversi keseluruhan kata melainkan hanya mengutip frasa-frasa tertentu yang telah dijabarkan dalam daftar kemampuan SIRI terdahulu.
- Analiser tata bahasa adalah software yang dirancang untuk memahami maksud dari sebuah kalimat yang diucapkan berdasarkan frasa kunci yang terkandung di dalamnya. Selain memanfaatkan frasa kunci, SIRI juga menggunakan analisis gramatika dan pencocokan string untuk memahami perintah atau pertanyaan yang Anda ajukan.
- Penyedia Layanan : social media facebook twitter, koneksi internet, peta, kontak, dll

CARA MENGGUNAKAN
Agar bisa mulai menggunakan Siri, terlebih
dahulu Anda harus memasukan nama Anda. Masuk ke menu Setting – General – SIRI –
My Info dan masukan nama Anda, selanjutnya pilih bahasa yang dipakai baik itu
UK English, US English, French, ataupun German. Meski untuk sekarang hanya
tersedia secara full yakni US English. Sayang sekali memang untuk Bahasa
Indonesia, belum tersedia! Jadi untuk menggunakan SIRI ini Anda wajib
menggunakan perintah Bahasa Inggris!
Untuk menggunakan SIRI, Anda
cukup tekan tombol Home di iPhone 4S tunggu sampai terdengar bunyi Beep dua
kali, selanjutnya akan muncul icon Microphone dan tulisan “What can I help you
with?” selanjutnya Anda tinggal masukan perintah kepada Siri semisal “Play
Marry You” atau “Play my Playlist number 7” jika Anda ingin mendengarkan lagu
Marry You dari Bruno Mars, tentunya pastikan di koleksi lagu iTunes Anda ada
lagu tersebut. Atau jika Anda ingin mengirim SMS ke sang adik tinggal masukan
perintah “Send Text Message to My Sister” pastikan nomor handphone sang adik
sudah ada di Phonebook dan di bagian relationshipnya sudah di set ke sister!
Saat memberikan perintah kepada
Siri, pastikan Anda mengucapkan kalimat perintah dengan jelas, jangan
terpotong-potong, jangan sampai Anda memberikan perintah “call my…..mmmm…. my
mother?” tentunya Siri akan sedikit bingung mendengar kalimat yang terpotong
dan tidak jelas. Selain itu pastikan perintah yang dimasukan juga jelas dan
lebih spesifik, jangan memberikan perintah yang terlalu umum, semisal “Call My
Phonebook” ini jelas akan membuat bingung? Masa harus menelepon setiap contact
yang ada di phonebook?

Keuntungan dari Siri:
- Anda dapat menemukan restoran terdekat dengan hanya mengemudi dan memberikan perintah ke iphone Anda melalui suara dengan teknologi siri.
- Anda dapat membaca pesan teks.
- Lihat peta.
- Membuat janji.
- Tunggu panggilan.
- Dan masih banyak banyak lagi manfaat dan keuntungan lainnya.

Dan berikut adalah beberapa kelemahan pada siri:
- Anda harus terhubung ke internet untuk menggunakan siri yang tidak dalam 3GS.
- Peta hanya diterjemahkan dalam bahasa Inggris kami sehingga Anda harus berbicara dalam bahasa Inggris kita yang lain itu tidak menemukan peta.
- Kadang perintah suara tidak diinterpretasikan oleh iphone saat Anda berbicara dan terjadi sesuatu yang tidak Anda inginkan.
- Untuk memakai Siri, Anda harus berada di tempat yang tidak bising agar suara Anda dapat ditangkap dengan baik.

Sumber:
Di berbagai media, Anda mungkin pernah menyaksikan Stephen Hawking
berbicara di depan mahasiswanya. Fisikawan yang terkenal dengan teori black
hole-nya ini sudah tidak mampu lagi mengeluarkan suara dari lisannya, namun
berkat teknologi speech synthesizer, dia masih bisa bercakap-cakap. Mesin
speech synthesizer Hawking memang cukup kompleks. Alat ini tidak hanya
memproduksi suara, tetapi juga menangkap input dari gerakan mata sang doktor.
Demikian pula, misalnya, dengan aplikasi voice command yang banyak tertanam di
smartphone mutakhir yang memadukan speech recognizer dengan speech synthesizer.

Aplikasi speech synthesizer yang paling sederhana sebenarnya ada
pada setiap PC ber-OS Windows. Bila anda menekan tuts Winkey + U di keyboard,
Windows akan mengaktifkan Utility Manager, yang di dalamnya terdapat aplikasi
Microsoft Narrator. Aplikasi ini akan membaca setiap jendela yang anda
aktifkan, termasuk tombol-tombol di dalamnya. Atau, mungkin anda pernah
menginstal aplikasi microsoft reader di PC. Aplikasi yang diperuntukkan bagi
file >LTT ini pun dilengkapi dengan kemampuan menerjemahkan teks menjadi
suara (text to speech) yang merupakan contoh teknologi speech sybthesizer.
Apa itu Speech Synthesis?
Speech synthesis adalah sebuah kemampuan bicara manusia yang
dibuat oleh manusia (artificial). Sebuah sistem komputer digunakan untuk tujuan
ini yang disebut sebagai speech synthesizer, dan dapat diimplementasikan ke
dalam software atau hardware. Sebagai contoh sebuah sistem text-to-speech (TTS)
yang dapat mengkonversikan teks dengan bahasa biasa menjadi suara.
Sebuah sistem komputer yang digunakan untuk tujuan ini
disebut speech synthesizer, dan dapat diimplementasikan
dalam perangkat lunak atau perangkat
keras produk. Sebuah teks-to-speech (TTS) sistem
mengkonversi teks bahasa normal menjadi berbicara; sistem lain
membuat representasi linguistik simbolik seperti transkripsi
fonetik ke dalam pidato, pidato disintesis dapat dibuat dengan menggabungkan potongan pidato
direkam yang disimpan dalam database. Sistem berbeda dalam ukuran unit pidato
disimpan, sebuah sistem yang menyimpan telepon atau diphones menyediakan
berbagai keluaran terbesar, tapi mungkin kurang jelas.

Speech
synthesis adalah transformasi dari teks ke arah suara (speech).
Transformasi ini mengkonversi teks ke pemadu suara (speech synthesis)
yang sebisa mungkin dibuat menyerupai suara nyata, disesuaikan dengan aturan –
aturan pengucapan bahasa.TTS (text to speech) dimaksudkan
untuk membaca teks elektronik dalam bentuk buku, dan juga untuk menyuarakan
teks dengan menggunakan pemaduan suara. Sistem ini dapat digunakan sebagai
sistem komunikasi, pada sistem informasi referral, dapat diterapkan untuk
membantu orang-orang yang kehilangan kemampuan melihat dan membaca.
Synthesized speech dapat diciptakan dengan menggabungkan beberapa
potongan-potongan dari pembicaraan/pidato yang sudah direkam dalam sebuah basis
data. Kualitas dari sebuah speech synthesizer dilihat dari kemiripannya dengan
suara manusia dan kemampuannya untuk bisa dipahami. Program TTS yang jelas
dapat membantu orang dengan gangguan visual atau ketidakmampuan membaca, untuk
mendengarkan pada pekerjaan yang tertulis dalam komputer. Banyak Sistem Operasi
komputer yang telah dimasukkan speech synthesizer sejak tahun 1980-an.
Sebuah sistem text-to-speech (atau "mesin") terdiri dari
dua bagian: front-end dan back-end . Front-end
memiliki dua tugas utama. Pertama, mengubah teks mentah berisi simbol
seperti angka dan singkatan menjadi setara dengan kata-kata
tertulis-out. Proses ini sering disebut normalisasi teks,
pra-pengolahan, atau tokenization . Front-end kemudian
memberikan transkripsi fonetik untuk setiap kata, dan membagi dan
menandai teks ke unit prosodi ,
seperti frase , klausa , dan kalimat . Proses
menetapkan transkripsi fonetik untuk kata-kata ini
disebut teks-ke-fonem atau grafem konversi -untuk-fonem. Transkripsi
fonetik dan informasi prosodi bersama-sama membentuk representasi linguistik
simbolik yang output dengan front-end. Back-end-sering disebut
sebagai synthesizer-maka mengubah representasi linguistik simbolik
menjadi suara. Dalam sistem tertentu, bagian ini meliputi perhitungan
dari target prosodi (kontur pitch, durasi fonem), yang kemudian dikenakan
pada pidato output.
Sejarah Speech Synthesis
Upaya yang paling awal
untuk menghasilkan lahirnya pemandu suara, pada abad XVIII. Terlepas dari
kenyataan bahwa upaya pertama adalah bentuk mesin mekanis, kita dapat
mengatakan hari ini bahwa synthesizer sudah berkualitas tinggi. Pada
tahun 1779 di
St Petersburg, Rusia Profesor Kratzenshtein Kristen fisiologis menjelaskan perbedaan antara lima vokal panjang (/ A /, / e /, / i /, / o /, dan / u /) dan membuat alat untuk menghasilkan mereka artifisial. Tahun 1791 di Wina, Wolfgang von Kempelen memperkenalkan nya “Akustik-Mekanik Mesin Speech”. Dalam sekitar pertengahan 1800-an Charles Wheatstone dibangun terkenal versi mesin berbicara von Kempelen’s.

St Petersburg, Rusia Profesor Kratzenshtein Kristen fisiologis menjelaskan perbedaan antara lima vokal panjang (/ A /, / e /, / i /, / o /, dan / u /) dan membuat alat untuk menghasilkan mereka artifisial. Tahun 1791 di Wina, Wolfgang von Kempelen memperkenalkan nya “Akustik-Mekanik Mesin Speech”. Dalam sekitar pertengahan 1800-an Charles Wheatstone dibangun terkenal versi mesin berbicara von Kempelen’s.
Generasi dari sistem
pemaduan suara ini dapat dibagi ke dalam 3 masa, yaitu:
1. Generasi
pertama (1962-1977). Format sintesis dari fonem adalah teknologi dominan.
Teknologi ini memanfaatkan aturan berdasarkan penguraian fonetik pada kalimat
untuk kontur frekuensi forman. Beberapa sintesis masih miskin atau kurang
dalam kejelasan dan kealamiannya.
2. Generasi
kedua (1977-1992). Metode pemadu suara adalah diphone diwakilkan dengan
parameter LPC. Hal tersebut menunujukkan bahwa kejelasan yang baik pada pemadu
suara dapat diperoleh dengan andal dari input teks dengan menggabungkan diphone
yang sesuai dengan unit. Kejelasan meningkat selama sintesis forman, tetapi
kealamian dari pemadu suara masih tetap rendah.
3. Generasi
ketiga (1992-sekarang). Generasi ini ditandai dengan metode ‘ sintesis
pemilihan unit’ yang diperkenalkan dan disempurnakan oelh Sagisaka di Labs ATR Kyoto. Hasil dari pemandu suara pada periode ini sangat
mendekati human-generated
speech pada bagian kejelasan dan kealamian,
Teknologi pemadu suara
modern melibatkan metode dan algoritma yang canggih dan rumit. alat pemadu
suara dari keluarga “Infovox” mungkin mejadi salah satu multi bahasa TTS
yang paling dikenal saat ini. Versi komersial pertamanya, Infovox-SA 101,
dikembangkan pada tahun 1982 di Institute Teknologi Royal, Swedia dan
didasarkan pada sintesis forman.
AT &
T Bell Laboratories (Lucent Technologies) juga memiliki tradisi yang sangat
panjang tentang pemandu suara (speech
synthesis). TTS lengkap yang pertama didemostrasikan di Boston pada tahun
1972 dan diliris pada tahun 1973. Hal ini didasarkan pada model artikulatoris
yang sikembangkan oleh Ceceil Coker (Klatt 1987). Pengembangan proses dari
sistem penggabungan sintesis ini dimulai oleh Joseph Olive pada pertengahan
tahun 1970-an (Bell Labs 1997). Sistem ini sekarang sudah tersedia untuk bahasa
Inggris, Perancis, Spanyol, Italia, Jerman, Rusia, Rumania, Cina, dan Jepang
(Mcbius et al 1996).
Perangkat Speech Synthesis
Pidato sistem sintesis berbasis komputer pertama diciptakan pada
akhir 1950-an. Pertama umum Inggris sistem text-to-speech dikembangkan
oleh Noriko Umeda et al. Pada tahun 1968 di Laboratorium
Elektroteknik, Jepang. Pada tahun 1961, fisikawan John Larry Kelly,
Jr dan Louis rekan Gerstman menggunakan IBM 704 komputer
untuk mensintesis pidato, acara yang paling menonjol dalam sejarah Bell
Labs . Kelly perekam suara synthesizer ( vocoder ) ulang
lagu " Daisy Bell ", dengan iringan musik dari Max
Mathews .Kebetulan, Arthur C. Clarke mengunjungi teman dan
kolega John Pierce di fasilitas Bell Labs Murray Hill. Clarke begitu
terkesan oleh demonstrasi bahwa ia digunakan dalam adegan klimaks dari
skenario-Nya untuk novel nya 2001: A Space Odyssey, di mana HAL
9000 komputer menyanyikan lagu yang sama seperti yang sedang ditidurkan
oleh astronot Dave Bowman. Meskipun keberhasilan pidato sintesis
murni elektronik, penelitian masih terus dilakukan ke synthesizer pidato
mekanis.
Handheld elektronik menampilkan sintesis pidato mulai muncul
pada 1970-an. Salah satu yang pertama adalah Telesensory Systems
Inc(TSI) Pidato + kalkulator portabel untuk orang buta pada tahun 1976. Perangkat
lain yang diproduksi terutama untuk tujuan pendidikan, seperti Bicara
& Eja , yang diproduksi oleh Texas Instruments pada tahun
1978. Fidelity merilis versi berbicara komputer catur elektronik pada
tahun 1979. Yang pertama video game yang memiliki fitur sintesis
pidato adalah 1.980 shoot 'em up arcade
game , Stratovox , dari Sun Electronics. Contoh lain
awal adalah versi arcade dari Berzerk , dirilis pada tahun yang
sama.Pertama multi-player permainan elektronik menggunakan sintesis
suara adalah Milton dari Milton Bradley Company , yang
memproduksi perangkat di tahun 1980.

Teknologi Speech Synthesis
Yang paling penting dalam kualitas sistem speech synthesis adalah
kealamian dan kejelasannya. Kealamaian menjelaskan bagaimana dekatnya suara
output dengan suara manusia, sementara kejelasan adalah dengan kemudahan di
mana output tersebut dapat dipahami. Speech synthesizer yang ideal adalah yang
alami dan jelas. Sistem speech synthesis biasanya mencoba untuk memaksimalkan
kedua karakteristik.
Kualitas terpenting dari sebuah aplikasi speech synthesizer adalah
seberapa alami dan inteligibel output yang dihasilkannya. Alami, artinya
seberapa dekat suara yang dihasilkan aplikasi speech synthesizer dengan suara
manusia. Sedangkan inteligibel adalah seberapa mudah output tersebut dipahami
oleh manusia. Semua aplikasi speech synthesizer berusaha untuk menghasilkan output
yang alami dan inteligibel sekaligus.
Sampai saat ini, ada banyak teknologi untuk meng-generate gelombang suara sintetis ini. Dua teknologi yang paling banyak digunakan adalah concatenative synthesis dan formant synthesis. Keduanya memiliki keunggulan dan kekurangan sendiri-sendiri.
Teknologi pertama, concatenative synthesis, berbasis pada rangkaian (atau merangkai bersama) segmen-segmen dari suara yang direkam. Umumnya, teknologi ini menghasilkan suara sintesis yang terdengar paling alami.Namun, perbedaan antara suara alami yang direkam dengan segmentasi gelombang bunyi kadang menghasilkan suara yang menggangu. Mirip seperti suara pemberitahuan nomor antrean di bank atau suara call center operator ponsel yang menyebutkan sisa pulsa dan masa berlaku kartu ponsel anda.
Teknologi kedua, formant synthesis, tidak menggunakan sampel suara manusia melainkan membuat suara sintesi menggunakan model akustik. Parameter-parameter seperti frekuensi dasar, alunan suara, dan tingkat kebisingan bervariasi dari waktu ke waktu untuk menciptakan gelombang suara buatan.
Kebanyakan aplikasi berbasis teknologi ini menghasilkan suara buatan (tidak alami) seperti suara robot. Melihat keterbatasan kedua teknologi ini dalam menghasilkan suara buatan, seperti kita harus sabar menunggu pengembangannya lebih lanjut dalam beberapa tahun atau dekade ke depan.
Sampai saat ini, ada banyak teknologi untuk meng-generate gelombang suara sintetis ini. Dua teknologi yang paling banyak digunakan adalah concatenative synthesis dan formant synthesis. Keduanya memiliki keunggulan dan kekurangan sendiri-sendiri.
Teknologi pertama, concatenative synthesis, berbasis pada rangkaian (atau merangkai bersama) segmen-segmen dari suara yang direkam. Umumnya, teknologi ini menghasilkan suara sintesis yang terdengar paling alami.Namun, perbedaan antara suara alami yang direkam dengan segmentasi gelombang bunyi kadang menghasilkan suara yang menggangu. Mirip seperti suara pemberitahuan nomor antrean di bank atau suara call center operator ponsel yang menyebutkan sisa pulsa dan masa berlaku kartu ponsel anda.
Teknologi kedua, formant synthesis, tidak menggunakan sampel suara manusia melainkan membuat suara sintesi menggunakan model akustik. Parameter-parameter seperti frekuensi dasar, alunan suara, dan tingkat kebisingan bervariasi dari waktu ke waktu untuk menciptakan gelombang suara buatan.
Kebanyakan aplikasi berbasis teknologi ini menghasilkan suara buatan (tidak alami) seperti suara robot. Melihat keterbatasan kedua teknologi ini dalam menghasilkan suara buatan, seperti kita harus sabar menunggu pengembangannya lebih lanjut dalam beberapa tahun atau dekade ke depan.
Kualitas yang paling penting dari sebuah sistem sintesis
pidato kewajaran dan dimengerti. kealamian menjelaskan seberapa
dekat output terdengar seperti suara manusia, sementara kejelasan adalah
kemudahan yang output dipahami. Speech synthesizer yang ideal adalah baik
alam dan dimengerti. Sistem sintesis pidato biasanya mencoba untuk
memaksimalkan kedua karakteristik.
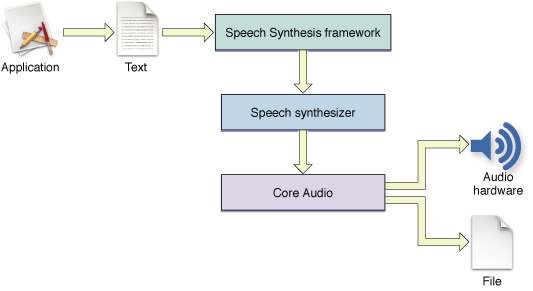
Dua teknologi utama dalam pembuatan gelombang suara synthetic speech
adalah Concatenative Synthesis dan Formant Synthesis. Setiap teknologi
mempunyai kekuatan dan kelemahannya, dan penggunaan yang ditujukan dari sistem
synthesis akan menentukkan pendekatan mana yang digunakan.
- A.
Concatenative Synthesis :
Concantenative synthesis didasarkan dengan penggabungan dari
segmen-segmen dari pembicaraan yang sudah direkam. Secara umum, concatenative
synthesis memproduksi synthesized speech dengan suara yang paling alami.
Tetapi, perbedaan antara variasi alami dalam pembicaraaan dan sifat dari teknik
otomasi untuk pensegmentasian gelombang suara terkadang menghasilkan kesalahan
suara dalam output. Namun, perbedaan antara variasi alami dalam pidato dan
sifat teknik otomatis untuk membagi bentuk gelombang kadang-kadang menyebabkan
gangguan terdengar pada output. Ada tiga sub-jenis utama dari sintesis
concatenative.
- Sintesis
Pemilihan unit
- Sintesis
Pemilihan unit menggunakan besar database pidato
direkam. Selama pembuatan database, setiap ucapan tercatat
tersegmentasi ke dalam beberapa atau semua hal berikut:
individu telepon , diphones ,
setengah-telepon, suku
kata , morfem , kata , frase ,
dan kalimat . Biasanya, pembagian ke dalam segmen
dilakukan dengan menggunakan dimodifikasi khusus recognizer
pidato disetel ke "keselarasan dipaksa" mode dengan
beberapa koreksi manual setelah itu, dengan menggunakan representasi
visual seperti yang gelombang dan spektogram .
Sebuah indeks unit dalam database pidato kemudian dibuat
berdasarkan segmentasi dan parameter akustik seperti frekuensi
dasar (lapangan ), durasi, posisi dalam suku kata, dan telepon
tetangga. Pada waktu berjalan , target ucapan yang
diinginkan dibuat dengan menentukan rantai terbaik unit calon dari
database (pemilihan unit). Proses ini biasanya dicapai dengan
menggunakan khusus tertimbang pohon keputusan .
- Pemilihan
unit menyediakan kealamian terbesar, karena hanya berlaku
sedikit pemrosesan sinyal digital (DSP) untuk pidato
direkam. DSP sering membuat pidato yang direkam terdengar kurang
alami, meskipun beberapa sistem menggunakan sejumlah kecil pengolahan
sinyal pada titik Rangkaian untuk menghaluskan bentuk
gelombang. Output dari yang terbaik unit-seleksi sistem sering
dibedakan dari suara manusia nyata, terutama dalam konteks dimana sistem
TTS telah disetel. Namun, kealamian maksimum biasanya membutuhkan
unit-pilihan database pidato menjadi sangat besar, dalam beberapa sistem
mulai ke gigabyte data dicatat, mewakili puluhan jam
berbicara. Juga, pilihan algoritma Unit telah dikenal untuk
memilih segmen dari Tempat yang menghasilkan kurang dari sintesis ideal
(misalnya kata-kata kecil menjadi tidak jelas) bahkan ketika pilihan
yang lebih baik ada dalam database. Baru-baru ini, peneliti telah
mengusulkan berbagai metode otomatis untuk mendeteksi segmen alami di
unit-pilihan sistem sintesis pidato.
- Sintesis
diphone
- Sintesis
diphone menggunakan database pidato minimal berisi
semua diphones (suara-to-suara transisi) yang terjadi dalam
suatu bahasa. Jumlah diphones tergantung
pada fonotaktik bahasa: misalnya, Spanyol memiliki sekitar 800
diphones, dan Jerman sekitar 2500. Dalam sintesis diphone, hanya satu
contoh dari setiap diphone terkandung dalam database pidato. Pada
saat runtime, target prosodi kalimat ditumpangkan pada
unit-unit minimal dengan cara pemrosesan sinyal digital teknik
seperti linear predictive coding ,PSOLA atau MBROLA.
Diphone sintesis menderita gangguan sonik sintesis concatenative dan
robot-terdengar sifat sintesis forman, dan memiliki beberapa keuntungan
baik pendekatan lain dari ukuran kecil. Dengan demikian,
penggunaannya dalam aplikasi komersial menurun, meskipun terus digunakan
dalam penelitian karena ada beberapa implementasi perangkat lunak
tersedia secara bebas.
- Domain-spesifik
sintesis
- Domain-spesifik
sintesis concatenates direkam sebelumnya kata dan frase untuk
menciptakan ucapan-ucapan yang lengkap. Hal ini digunakan dalam
aplikasi di mana berbagai teks output sistem akan terbatas pada domain
tertentu, seperti jadwal angkutan pengumuman atau laporan cuaca.
Teknologi ini sangat sederhana untuk menerapkan, dan telah digunakan
secara komersial untuk waktu yang lama , dalam perangkat seperti
berbicara jam dan kalkulator. Tingkat kealamian sistem ini bisa
sangat tinggi karena berbagai jenis kalimat terbatas, dan mereka cocok
dengan prosodi dan intonasi dari rekaman asli.
- Karena
sistem ini dibatasi oleh kata-kata dan frasa dalam database mereka,
mereka tidak tujuan umum dan hanya dapat mensintesis kombinasi kata dan
frase yang mereka telah terprogram. Campuran kata-kata dalam bahasa
alami diucapkan namun masih dapat menyebabkan masalah kecuali banyak
variasi diperhitungkan. Misalnya, dalam non-rhotic dialek
dari bahasa Inggris "r" dalam kata-kata seperti "jelas" /
klɪə / biasanya
hanya diucapkan ketika kata berikut memiliki vokal sebagai huruf pertama
(misalnya"membersihkan" direalisasikan sebagai / ˌklɪəɾʌʊt
/ ). Demikian juga di Perancis , banyak konsonan
akhir menjadi tidak lagi diam jika diikuti oleh sebuah kata yang dimulai
dengan vokal, efek
yang disebut penghubung . Ini pergantian tidak
bisa direproduksi oleh sistem kata-Rangkaian sederhana, yang akan
membutuhkan kompleksitas tambahan untuk konteks-sensitif .

- B.
Formant Synthesis :
Formant synthesis tidak menggunakan pembicaraan manusia sebagai
sample pada runtime. Daripada itu, synthesized speech yang dihasilkan dibuat
dengan additive synthesis dan sebuah model akustik (physical modelling
synthesis).
Parameter seperti frekuensi dasar, penyuaraan, dan tingkat
kebisingan di variasikan dari waktu ke waktu untuk menciptakan gelombang buatan
(artificial) dari sebuah pembicaraan. Banyak sistem yang berdasarkan formant
synthesis menciptakan pembicaraan yang seperti robot yang tidak mungkin dapat
dikenal sebagai suara manusia. Tetapi, kealamian maksimum bukan selalu tujuan
dari sebuah sistem speech synthesis, dan sistem formant synthesis mempunyai
keuntungan dari sistem concatenative. Pembicaraan yang di-formant synthesis-kan
dapat menjadi sangat jelas, bahkan dalam kecepatan yang tinggi, sehingga
menghindari kesalahan suara yang sering dialami sistem concatenative.
Formant synthesis biasanya program yang lebih kecil dari
concatenative sistem karena ia tidak menggunakan basis data dari sampel-sampel
pembicaraan. Oleh karena itu formant synthesis dapat ditanamkan dalam sistem
yang mempunyai memory dan microprosesor yang terbatas. Karena sistem yang
berdasarkan formant mempunyai kendali penuh dari sluruh aspek dari hasil
pembicaraan, variasi yang luas dari prosodi dan intonasi dapat dihasilkan, menyampaikan
tidak hanya pertanyaan dan pernyataan tetapi juga emosi dan nada suara.

Forman sintesis tidak menggunakan sampel suara manusia pada
saat runtime. Sebaliknya, keluaran suara yang disintesis dibuat
menggunakan aditif sintesis dan model akustik (sintesis pemodelan
fisik ). Parameter seperti frekuensi
dasar , menyuarakan , dan kebisingan tingkat yang
bervariasi dari waktu ke waktu untuk membuat gelombang pidato
buatan. Metode ini kadang-kadang disebut aturan berbasis
sintesis; Namun, banyak sistem concatenative juga memiliki aturan berbasis
komponen. Banyak sistem yang didasarkan pada teknologi sintesis forman
menghasilkan buatan, robot yang terdengar pidato yang tidak akan pernah salah
untuk pidato manusia. Namun, kealamian maksimum tidak selalu tujuan sistem
sintesis pidato, dan sistem sintesis forman memiliki keunggulan dibandingkan
sistem concatenative. Pidato forman-disintesis dapat diandalkan
dimengerti, bahkan pada kecepatan yang sangat tinggi, menghindari Glitches
akustik yang biasanya wabah sistem concatenative. Kecepatan tinggi
disintesis pidato digunakan oleh tunanetra untuk navigasi cepat komputer
menggunakan pembaca layar . Synthesizer forman adalah program
biasanya lebih kecil dibandingkan dengan sistem concatenative karena mereka
tidak memiliki database contoh pidato. Karena itu mereka dapat digunakan
dalam embedded system , di
mana memori dan mikroprosesor daya terutama
terbatas. Karena sistem berbasis forman memiliki kontrol penuh dari semua
aspek pidato output, berbagai prosodies dan intonasi dapat menjadi
output, tidak hanya menyampaikan pertanyaan dan pernyataan, tetapi berbagai
emosi dan nada suara.
Contoh non-real-time tapi sangat akurat kontrol intonasi dalam
sintesis forman meliputi pekerjaan yang dilakukan pada akhir tahun 1970
untuk Texas Instruments mainan Bicara & Eja , dan pada
awal tahun 1980 Sega arcade mesin dan dalam banyak Atari,
Inc. game arcade menggunakan TMS5220 LPC
Chips . Menciptakan intonasi yang tepat untuk proyek ini adalah
telaten, dan hasilnya masih harus dicocokkan dengan real-time text-to-speech
interface.
- C. Sintesis
artikulatoris
Sintesis artikulatoris mengacu pada teknik komputasi untuk
sintesis pidato berdasarkan model manusia saluran vokal dan
artikulasi proses yang terjadi di sana. Synthesizer artikulatoris pertama
teratur digunakan untuk percobaan laboratorium dikembangkan di Haskins
Laboratories di pertengahan 1970-an oleh Philip Rubin , Tom
Baer, dan Paul
Mermelstein. Synthesizer ini, yang dikenal sebagai ASY, didasarkan pada
model saluran vokal dikembangkan di Bell Laboratories pada tahun 1960
dan 1970-an oleh Paul Mermelstein, Cecil Coker, dan rekan.
Sampai saat ini, model sintesis artikulatoris belum dimasukkan ke
dalam sistem sintesis pidato komersial. Sebuah pengecualian
adalah NeXT sistem berbasis awalnya dikembangkan dan dipasarkan oleh
Trillium Suara Research, sebuah perusahaan spin-off dari University of
Calgary , di mana banyak riset asli dilakukan. Setelah runtuhnya
berbagai inkarnasi NeXT (dimulai oleh Steve Jobs pada akhir tahun
1980 dan bergabung dengan Apple Computer pada tahun 1997), perangkat lunak
TRILLIUM diterbitkan di bawah GNU General Public License , dengan
bekerja terus sebagai gnuspeech . Sistem, pertama kali
dipasarkan pada tahun 1994, memberikan penuh text-to-speech konversi berbasis
artikulatoris menggunakan Waveguide atau transmisi-line analog dari saluran
mulut dan hidung manusia dikendalikan oleh Carré ini "model daerah
khas".
- D.
Sintesis berbasis HMM
Sintesis berbasis HMM adalah metode sintesis
berdasarkan model Markov tersembunyi , juga disebut statistik
Parametrik Sintesis. Dalam sistem ini, spektrum
frekuensi ( vokal ),frekuensi dasar (sumber vokal), dan
durasi ( prosodi ) berbicara dimodelkan secara bersamaan oleh
HMMs. Pidato bentuk gelombang yang dihasilkan dari HMMs sendiri
berdasarkan kemungkinan maksimum kriteria.
- E.
Sintesis Sinewave
Sintesis sinewave adalah teknik untuk sintesis pidato dengan
mengganti forman (band utama energi) dengan peluit nada murni.
Ada beberapa masalah yang
terdapat pada pemaduan suara, yaitu:
- User
sangat sensitif terhadap variasi dan informasi suara. Oleh sebab itu,
mereka tidak dapat memberikan toleransi atas ketidaksempurnaan pemadu
suara.
- Output
dalam bentuk suara tidak dapat diulang atau dicari dengan mudah.
- Meningkatkan
keberisikan pada lingkungan kantor atau jika menggunakan handphone, maka
akan meningkatkan biaya pengeluaran.

- Bagi
tunanetra, pemadu suara menawarkan media komunkasi dimana mereka dapat
memiliki akses yang tidak terbatas.
- Lingkungan
dimana visual dan haptic skill user berfokus pada hal lain. Contohnya:
sinyal bahaya pada kokpit pesawat udara.
Kesimpulan:
Speech synthesis adalah sebuah kemampuan bicara
manusia yang dibuat oleh manusia (artificial) dimana computer dapat mentransformasikan sebuah data berbentuk teks (text) ke
arah suara (speech). Oleh karena itu, speech synthesis juga
sering dikenal dengan teknologi Text-to-Speech. Namun selain itu, Speech Syntesis tidak selamanya memerlukan text sebagai data inputnya. Seperti yang diterapkan ilmuwan terkenal Stepehen Hawking, ia memanfaatkan AI dengan memanfaatkan, menghubungkan dan memanipulasi saraf biologis dengan teknologi dan alat super canggih sehingga menghasilkan output suara pada mesin yang dipakainya untuk berkomunikasi.
Sumber:
PENGERTIAN SPEECH RECOGNITION
Pengenalan ucapan atau pengenalan
wicara—dalam istilah bahasa Inggrisnya, automatic speech recognition (ASR)—adalah
suatu pengembangan teknik dan sistem yang memungkinkan komputer untuk
menerima masukan berupa kata yang diucapkan. Teknologi ini memungkinkan suatu
perangkat untuk mengenali dan memahami kata-kata yang diucapkan dengan cara digitalisasi kata
dan mencocokkan sinyal digital tersebut
dengan suatu pola tertentu yang tersimpan dalam suatu perangkat. Kata-kata yang
diucapkan diubah bentuknya menjadi sinyal digital dengan cara mengubah gelombang
suara menjadi sekumpulan angka yang kemudian disesuaikan dengan
kode-kode tertentu untuk mengidentifikasikan kata-kata tersebut. Hasil dari
identifikasi kata yang diucapkan dapat ditampilkan dalam bentuk tulisan atau
dapat dibaca oleh perangkat teknologi sebagai sebuah komando untuk melakukan
suatu pekerjaan, misalnya penekanan tombol pada telepon
genggam yang dilakukan secara otomatis dengan komando suara.

Speech Recognition yang
juga dikenal sebagai Automatic Speech Recognition atau Computer
Speech Recognition, dapat mengkonversikan kata-kata lisan menjadi teks. Istilah
“pengenalan suara” terkadang digunakan untuk merujuk kepada sistem pengenalan
yang harus dilatih untuk pembicara tertentu, sebagai suatu kasus khusus untuk
kebanyakan pengenalan perangkat lunak desktop. Mengenali pembicara dapat
menyederhanakan tugas menerjemahkan pembicaraan.
Speech
recognition adalah solusi yang lebih luas yang mengacu pada teknologi yang
dapat mengenali pembicaraan tanpa ditargetkan pada pembicara tunggal seperti sistem call
center yang dapat mengenali suara dengan sendirinya.
Aplikasi speech recognition mencakup voice user interface seperti voice dialing, call routing, pengendali alat domotic, pencarian, memasukkan data sederhana, persiapan dokumen terstruktur, pemrosesan speech-to-text, dan pesawat.
Aplikasi speech recognition mencakup voice user interface seperti voice dialing, call routing, pengendali alat domotic, pencarian, memasukkan data sederhana, persiapan dokumen terstruktur, pemrosesan speech-to-text, dan pesawat.
Speech Recognition adalah proses
konversi sebuah sinyal akustik, yang ditangkap oleh microphone atau telepon,
untuk merangkai kata kata. Kata - kata yang dikenali bisa jadi sebagai hasil
akhir, untuk sebuah aplikasi seperti command & control, penginputan data,
dan persiapan dokumen. Speech Recognition adalah proses identifikasi suara
berdasarkan kata yang diucapkan dengan melakukan konversi sebuah sinyal
akustik, yang ditangkap oleh audio device (perangkat input suara).
Alat pengenal ucapan, yang sering
disebut dengan speech recognizer, membutuhkan sampel kata sebenarnya yang
diucapkan dari pengguna. Sampel kata akan didigitalisasi, disimpan dalam komputer, dan
kemudian digunakan sebagai basis data dalam mencocokkan kata yang diucapkan
selanjutnya. Sebagian besar alat pengenal ucapan sifatnya
masih tergantung kepada pembicara. Alat ini hanya dapat mengenal kata yang
diucapkan dari satu atau dua orang saja dan hanya bisa mengenal kata-kata
terpisah, yaitu kata-kata yang dalam penyampaiannya terdapat jeda antar kata.
Hanya sebagian kecil dari peralatan yang menggunakan teknologi ini yang
sifatnya tidak tergantung pada pembicara. Alat ini sudah dapat mengenal kata
yang diucapkan oleh banyak orang dan juga dapat mengenal kata-kata kontinu,
atau kata-kata yang dalam penyampaiannya tidak terdapat jeda antar kata.

Pengenalan ucapan dalam
perkembangan teknologinya merupakan bagian dari pengenalan suara (proses
identifikasi seseorang berdasarkan suaranya). Pengenalan suara sendiri terbagi
menjadi dua, yaitu pengenalan pembicara (identifikasi suara berdasarkan orang
yang berbicara) dan pengenalan ucapan (identifikasi suara berdasarkan kata yang
diucapkan).
Speech Recognition juga merupakan
sistem yang digunakan untuk mengenali perintah kata dari suara manusia dan kemudian diterjemahkan menjadi suatu data yang dimengerti oleh komputer. Pada saat ini, sistem ini digunakan untuk menggantikan peranan input dari keyboard dan mouse.
Keuntungan dari sistem ini adalah
pada kecepatan dan kemudahan dalam penggunaannya. Kata – kata yang ditangkap
dan dikenali bisa jadi sebagai hasil akhir, untuk sebuah aplikasi seperti
command & control, penginputan data, dan persiapan dokumen. Parameter yang
dibandingkan ialah tingkat penekanan suara yang kemudian akan dicocokkan dengan
template database yang tersedia. Sedangkan sistem pengenalan suara berdasarkan
orang yang berbicara dinamakan speaker recognition. Pada makalah ini hanya akan
dibahas mengenai speech recognition karena kompleksitas algoritma yang
diimplementasikan lebih sederhana daripada speaker recognition. Algoritma yang
akan diimplementasikan pada bahasan mengenai proses speech recognition ini
adalah algoritma FFT (Fast Fourier Transform), yaitu algoritma yang cukup
efisien dalam pemrosesan sinyal digital (dalam hal ini suara) dalam bentuk
diskrit. Algoritma ini mengimplementasikan algoritma Divide and Conquer untuk
pemrosesannya. Konsep utama algoritma ini adalah mengubah sinyal suara yang
berbasis waktu menjadi berbasis frekuensi dengan membagi masalah menjadi
beberapa upa masalah yang lebih kecil. Kemudian, setiap upa masalah diselesaikan
dengan cara melakukan pencocokan pola digital suara.
Speech recognition atau
pengenalan pembicaraan (juga dikenal sebagai pengenalan suara otomatis atau
pengakuan komputer pidato) mengkonversi diucapkan kata-kata untuk teks. The
"pengenalan suara" istilah kadang-kadang digunakan untuk merujuk
kepada sistem pengakuan yang harus dilatih untuk kasus-speaker tertentu seperti
untuk perangkat lunak pengenal yang paling desktop.Menyadari pembicara dapat menyederhanakan
tugas menerjemahkan pidato. Pengenalan pembicaraan adalah solusi yang lebih
luas yang mengacu pada teknologi yang dapat mengenali pidato tanpa ditargetkan
pada pembicara tunggal seperti sistem call center yang dapat mengenali suara
sewenang-wenang.

Aplikasi pengenalan pembicaraan
termasuk user interface seperti suara panggilan suara (misalnya, "Call
home"), call routing (misalnya, "Saya ingin membuat collect
call"), kontrol alat domotic, pencarian (misalnya, menemukan podcast di mana
tertentu Kata-kata itu diucapkan), sederhana entri data (misalnya, memasukkan
nomor kartu kredit), persiapan dokumen terstruktur (misalnya, sebuah laporan
radiologi), pengolahan pidato-ke-teks (misalnya, kata prosesor atau email), dan
pesawat udara (biasanya disebutInput langsung suara).
Secara umum, speech recognizer
memproses sinyal suara yang masuk dan menyimpannya dalam bentuk digital. Hasil
proses digitalisasi tersebut kemudian dikonversi dalam bentuk spektrum suara
yang akan dianalisa dengan membandingkan dengan template suara pada database
sistem. Sebelumnya, data suara masukan dipilah-pilah dan diproses satu per satu
berdasarkan urutannya. Pemilahan ini dilakukan agar proses analisis dapat
dilakukan secara paralel.
Speech recognition merupakan
salah satu jenis biometric recognition,yaitu proses komputer mengenali apa yang
diucapkan seseorang berdasarkan intonasi suara yang dikonversi ke dalam bentuk
digital print.
Pengenalan pola suara adalah
salah satu aplikasi yang berkembang saat ini. Sistem ini mengijinkan kita untuk
berkomunikasi antara manusia dengan memasukkan data ke komputer. Salah satu
fungsinya adalah untuk meningkatkan efisiensi industri manufaktur, mengontrol
mesin dengan berbicara pada mesin itu. Algoritma yang diimplementasikan untuk
masalah pengenalan suara ini adalah algoritma divide and conquer. Proses
awalnya adalah mengkonversi data spektrum suara ke dalam bentuk digital dan
mengibah dalam bentuk diskrit.
SEJARAH SPEECH RECOGNITION
Sejak tahun 1940, perusahaan American
Telephone and Telegraph Company (AT&T) sudah mulai mengembangkan suatu
perangkat teknologi yang dapat mengidentifikasi kata yang diucapkan manusia.
Sekitar tahun 1960-an, para peneliti dari perusahaan tersebut sudah berhasil
membuat suatu perangkat yang dapat mengidentifikasi kata-kata terpisah dan pada
tahun 1970-an mereka berhasil membuat perangkat yang dapat mengidentifikasi
kata-kata kontinu. Alat pengenal ucapan kemudian menjadi sangat fungsional
sejak tahun 1980-an dan masih dikembangkan dan terus ditingkatkan
keefektifannya hingga sekarang.

Biometrik, termasuk di dalamnya
speech recognition, secara umum digunakan untuk identifikasi dan verifikasi.
Identifikasi ialah mengenali identitas subyek, dilakukan perbandingan kecocokan
antara data biometric subyek dalam database berisi record karakter subyek.
Sedangkan verifikasi adalah menentukan apakah subyek sesuai dengan apa yang
dikatakan terhadap dirinya.
Biometrik merupakan suatu metoda
untuk mengenali manusia berdasarkan pada satu atau lebih ciri-ciri fisik atau
tingkah laku yang unik. Biometric Recognition atau biasa disebut dengan Sistem
pengenalan biometric mengacu pada identifikasi secara otomatis terhadap manusia
berdasarkan psikological atau karakteristik tingkah laku manusia. Ada beberapa
jenis teknologi biometric antara lain suara (speech recognition). Speech
recognizer yang pertama keluar di tahun 1952. Salah satu perangkat speech
recognizer adalah IBM Shoebox, yang dikeluarkan pada 1963 melalui New York
World's Fair.
Metode Hidden Markov Model mulai
diperkenalkan dan dipelajari pada akhir tahun 1960, metode yang berupa model
statistik dari rantai Markov ini semakin banyak dipakai pada tahun-tahun
terakhir terutama dalam bidang speech recognition, seperti dijelaskan oleh
Lawrence R. Rabiner dalam laporannya yang berjudul “A Tutorial on Hidden Markov
Models and Selected Applications in Speech Recognition”
Proses dalam dunia nyata secara
umum menghasilkan observable output yang dapat dikarakterisasikan sebagai
signal. Signal bisa bersifat diskrit (karakter dalam alfabet) maupun kontinu
(pengukuran temperatur, alunan musik). Signal bisa bersifat stabil (nilai
statistiknya tidak berubah terhadap waktu) maupun nonstabil (nilai signal
berubah-ubah terhadap waktu). Dengan melakukan pemodelan terhadap signal secara
benar, dapat dilakukan simulasi terhadap sumber dan pelatihan sebanyak mungkin
melalui proses simulasi tersebut. Sehingga model dapat diterapkan dalam sistem
prediksi, sistem pengenalan, maupun sistem identifikasi. Secara garis besar
model signal dapat dikategorikan menjadi 2 golongan yaitu : model deterministik
dan model statistikal. Model deterministik menggunakan nilai-nilai properti
dari sebuah signal seperti :amplitudo, frekuensi, fase dari gelombang sinus.
Sedangkan model statistikal menggunakan nilai-nilai statistik dari sebuah
signal seperti: proses Gaussian, proses Poisson, proses Markov, dan proses
Hidden Markov.
SKEMA UTAMA DAN ALGORITMA SPEECH RECOGNITION
Terdapat 4 langkah utama dalam
sistem pengenalan suara:
- Penerimaan data input
- Ekstraksi, yaitu penyimpanan data masukan sekaligus pembuatan database untuk template.
- Pembandingan / pencocokan, yaitu tahap pencocokan data baru dengan data suara (pencocokan tata bahasa) pada template.
- Validasi identitas pengguna.

Secara umum, speech recognizer
memproses sinyal suara yang masuk dan menyimpannya dalam bentuk digital. Hasit
proses digitalisasi tersebut kemudian dikonversi dalam bentuk spektrum suara
yang akan dianalisa dengan membandingkannya dengan template suara pada database
sistem.
Sebelumnya, data suara masukan
dipilah-pilah dan diproses satu per satu berdasarkan urutannya. Pemilahan ini
dilakukan agar proses analisis dapat dilakukan secara paralel. Proses yang
pertama kali dilakukan ialah memproses gelombang kontinu spektrum suara ke
dalam bentuk diskrit. Langkah berikutnya ialah proses kalkulasi yang dibagi
menjadi dua bagian :
- Transformasi gelombang diskrit menjadi array data.
- Untuk masing-masing elemen pada aiTay data, hitung "ketinggian" gelombang (frekuensi). Objek permasaiahan yang akan dibagi adalah masukan berukuran n, berupa data diskrit gelombang suara.
Ketika mengkonversi gelombang
suara ke dalam bentuk diskrit, gelombang diperlebar dengan cara memperinci
berdasarkan waktu. Hal ini dilakukan agar proses algontma seianjutnya
(pencocokan) lebih mudah diiakukan. Namun, efek buruknya ialah array of array
data yang terbentuk akan lebih banyak.
Dari tiap elemen array data
tersebut, dikonversi ke dalam bentuk bilangan biner. Data biner tersebut yang
nantinya akan dibandingkan dengan template data suara.
Proses divide and conquer:
Proses divide and conquer:
- Pilih sebuah angkaN, dimana N merupakan bilangan bulat kelipatan 2.Bilangan ini berfungsi untuk menghitung jumlah elemen transformasi FFT.
- Bagi dua data diskrit secara (dengan menerapkan algoritma divide and conquer) menjadi data diskrit yang lebih kecii berukuran N = N,.N2.
- Objek data dimasukkan ke dalam table (sebagai elemen tabel).
- Untuk setiap eiemen data, dicocokkan dengan data pada template (pada data template juga dilakukan pemrosesan digitaiisasi menjadi data diskrit, dengan cara yang sama dengan proses digitaiisasi data masukan bam yang ingin dicocokkan).
- Setiap masalah disatukan kembali dan dianalisis secara keseluruhan, kecocokan dari segi tata bahasa dan apakah data yang diucapkan sesuai dengan kata yang tersedia pada template data.
- Verifikasi data. Jika sesuai, proses iebih lanjut, sesuai dengan aplikasi yang mengimplementasikan algoritma ini.

JENIS-JENIS SPEECH RECOGNITION
Berdasarkan kemampuan dalam
mengenal kata yang diucapkan, terdapat 5 jenis pengenalan kata, yaitu :
- Kata-kata yang terisolasi : Proses pengidentifikasian kata yang hanya dapat mengenal kata yang diucapkan jika kata tersebut memiliki jeda waktu pengucapan antar kata
- Kata-kata yang berhubungan : Proses pengidentifikasian kata yang mirip dengan kata-kata terisolasi, namun membutuhkan jeda waktu pengucapan antar kata yang lebih singkat
- Kata-kata yang berkelanjutan : Proses pengidentifikasian kata yang sudah lebih maju karena dapat mengenal kata-kata yang diucapkan secara berkesinambungan dengan jeda waktu yang sangat sedikit atau tanpa jeda waktu. Proses pengenalan suara ini sangat rumit karena membutuhkan metode khusus untuk membedakan kata-kata yang diucapkan tanpa jeda waktu. Pengguna perangkat ini dapat mengucapkan kata-kata secara natural
- Kata-kata spontan : Proses pengidentifikasian kata yang dapat mengenal kata-kata yang diucapkan secara spontan tanpa jeda waktu antar kata
- Verifikasi atau identifikasi suara : Proses pengidentifikasian kata yang tidak hanya mampu mengenal kata, namun juga mengidentifikasi siapa yang berbicara.
PROSES KERJA ALAT SPEECH RECOGNITION
Alat pengenal ucapan memiliki
empat tahapan dalam prosesnya, yaitu :
- Tahap penerimaan masukan : Masukan berupa kata-kata yang diucapkan lewat pengeras suara.
- Tahap ekstraksi : Tahap ini adalah tahap penyimpanaan masukan yang berupa suara sekaligus pembuatan basis data sebagai pola. Proses ekstraksi dilakukan berdasarkan metode Model Markov Tersembunyi atau Hidden Markov Model (HMM), yang merupakan model statistik dari sebuah sistem yang diasumsikan oleh Markov sebagai suatu proses dengan parameter yang tidak diketahui. Tantangan dalam model statistik ini adalah menentukan parameter-parameter tersembunyi dari parameter yang dapat diamati. Parameter-parameter yang telah kita tentukan kemudian digunakan untuk analisis yang lebih jauh pada proses pengenalan kata yang diucapkan. Berdasarkan HMM, proses pengenalan ucapan secara umum menghasilkan keluaran yang dapat dikarakterisasikan sebagai sinyal. Sinyal dapat bersifat diskrit (karakter dalam abjad) maupun kontinu (pengukuran temperatur, alunan musik). Sinyal dapat pula bersifat stabil (nilai statistiknya tidak berubah terhadap waktu) maupun nonstabil (nilai sinyal berubah-ubah terhadap waktu). Dengan melakukan pemodelan terhadap sinyal secara benar, dapat dilakukan simulasi terhadap masukan dan pelatihan sebanyak mungkin melalui proses simulasi tersebut sehingga model dapat diterapkan dalam sistem prediksi, sistem pengenalan, maupun sistem identifikasi. Secara garis besar model sinyal dapat dikategorikan menjadi dua golongan, yaitu: model deterministik dan model statistikal. Model deterministik menggunakan nilai-nilai properti dari sebuah sinyal seperti: amplitudo, frekuensi, dan fase dari gelombang sinus. Model statistikal menggunakan nilai-nilai statistik dari sebuah sinyal seperti: proses Gaussian, proses Poisson, proses Markov, dan proses Markov Tersembunyi. Suatu model HMM secara umum memiliki unsur-unsur sebagai berikut:
- N, yaitu jumlah bagian dalam model. Secara umum bagian tersebut saling terhubung satu dengan yang lain, dan suatu bagian bisa mencapai semua bagian yang lain, serta sebaliknya (disebut dengan model ergodik). Namun hal tersebut tidak mutlak karena terdapat kondisi lain dimana suatu bagian hanya bisa berputar ke diri sendiri dan berpindah ke satu bagian berikutnya. Hal ini bergantung pada implementasi dari model.
- M, yaitu jumlah simbol observasi secara unik pada tiap bagiannya, misalnya: karakter dalam abjad, dimana bagian diartikan sebagai huruf dalam kata.
- Probabilita Perpindahan Bagian { } = ij A a
- Probabilita Simbol Observasi pada bagian j, { } () = j Bb k
- Inisial Distribusi Bagian i p p . Dengan memberikan nilai pada N, M, A, B, dan p , HMM dapat digunakan sebagai generator untuk menghasilkan urutan observasi. dimana tiap observasi t o adalah salah satu simbol dari V, dan T adalah jumlah observasi dalam suatu sequence.
- Setelah memberikan nilai N, M, A, B, dan p , maka proses ekstraksi dapat diurutkan. Berikut adalah tahapan ekstraksi pengenalan ucapan berdasarkan HMM :
- Tahap ekstraksi tampilan : Penyaringan sinyal suara dan pengubahan sinyal suara analog ke digital
- Tahap tugas pemodelan : Pembuatan suatu model HMM dari data-data yang berupa sampel ucapan sebuah kata yang sudah berupa data digital
- Tahap sistem pengenalan HMM : Penemuan parameter-parameter yang dapat merepresentasikan sinyal suara untuk analisis lebih lanjut.
- Tahap pembandingan : Tahap ini merupakan tahap pencocokan data baru dengan data suara (pencocokan tata bahasa) pada pola. Tahap ini dimulai dengan proses konversi sinyal suara digital hasil dari proses ekstraksi ke dalam bentuk spektrum suara yang akan dianalisa dengan membandingkannya dengan pola suara pada basis data. Sebelumnya, data suara masukan dipilah-pilah dan diproses satu per satu berdasarkan urutannya. Pemilihan ini dilakukan agar proses analisis dapat dilakukan secara paralel. Proses yang pertama kali dilakukan ialah memproses gelombang kontinu spektrum suara ke dalam bentuk diskrit. Langkah berikutnya ialah proses kalkulasi yang dibagi menjadi dua bagian :
- Transformasi gelombang diskrit menjadi data yang terurut : Gelombang diskrit berbentuk masukan berukuran n yang menjadi objek yang akan dibagi pada proses konversi dengan cara pembagian rincian waktu
- Menghitung frekuensi pada tiap elemen data yang terurut
- Selanjutnya tiap elemen dari data yang terurut tersebut dikonversi ke dalam bentuk bilangan biner. Data biner tersebut nantinya akan dibandingkan dengan pola data suara dan kemudian diterjemahkan sebagai keluaran yang dapat berbentuk tulisan ataupun perintah pada perangkat.
- Tahap validasi identitas pengguna: Alat pengenal ucapan yang sudah memiliki sistem verifikasi/identifikasi suara akan melakukan identifikasi orang yang berbicara berdasarkan kata yang diucapkan setelah menerjemahkan suara tersebut menjadi tulisan atau komando.
IMPLEMENTASI SPEECH RECOGNITION
Hardware yang dibutuhkan dalam
implementasi Speech Recognition :
- Sound card : Merupakan perangkat yang ditambahkan dalam suatu Komputer yang fungsinya sebagai perangkat input dan output suara untuk mengubah sinyal elektrik, menjadi analog maupun menjadi digital.
- Microphone : Perangkat input suara yang berfungsi untuk mengubah suara yang melewati udara, air dari benda orang menjadi sinyal elektrik.
- Komputer atau Komputer Server : Dalam proses suara digital menterjemahkan gelombang suara menjadi suatu simbol biasanya menjadi suatu nomor biner yang dapat diproses lagi kemudian diidentifikasikan dan dicocokan dengan database yang berisi berkas suara agar dapat dikenali.

APLIKASI ALAT SPEECH RECOGNITION
- Bidang Komunikasi
- Komando Suara: Komando Suara adalah suatu program pada komputer yang melakukan perintah berdasarkan komando suara dari pengguna. Contohnya pada aplikasi Microsoft Voice yang berbasis bahasa Inggris. Ketika pengguna mengatakan “Mulai kalkulator” dengan intonasi dan tata bahasa yang sesuai, komputer akan segera membuka aplikasi kalkulator. Jika komando suara yang diberikan sesuai dengan daftar perintah yang tersedia, aplikasi akan memastikan komando suara dengan menampilkan tulisan “Apakah Anda meminta saya untuk ‘mulai kalkulator’?”. Untuk melakukan verifikasi, pengguna cukup mengatakan “Lakukan” dan komputer akan langsung beroperasi.

- Pendiktean : Pendiktean adalah sebuah proses mendikte yang sekarang ini banyak dimanfaatkan dalam pembuatan laporan atau penelitian. Contohnya pada aplikasi Microsoft Dictation yang merupakan aplikasi yang dapat menuliskan apa yang diucapkan oleh pengguna secara otomatis.
- Telepon : Pada telepon, teknologi pengenal ucapan digunakan pada proses penekanan tombol otomatis yang dapat menelpon nomor tujuan dengan komando suara.
- Bidang Kesehatan
- Alat pengenal ucapan banyak digunakan dalam bidang kesehatan untuk membantu para penyandang cacat dalam beraktivitas. Contohnya pada aplikasi Antarmuka Suara Pengguna atau Voice User Interface (VUI) yang menggunakan teknologi pengenal ucapan dimana pengendalian saklar lampu misalnya, tidak perlu dilakukan secara manual dengan menggerakkan saklar tetapi cukup dengan mengeluarkan perintah dalam bentuk ucapan sebagai saklarnya. Metode ini membantu manusia yang secara fisik tidak dapat menggerakkan saklar karena cacat pada tangan misalnya. Penerapan VUI ini tidak hanya untuk lampu saja tapi bisa juga untuk aplikasi-aplikasi kontrol yang lain.
- Peralatan elektronik yang menyimpan riwayat kesehatan atau Electronic Medical Records(EMR) dapat digunakan secara lebih efektif bila menggunakan teknologi speech recognition. Proses pencarian, pertanyaan dan pencarian akan lebih mudah bila menggunakan suara daripada menggunakan keyboard.
- Bidang Militer
- Pelatihan Penerbangan : Aplikasi alat pengenal ucapan dalam bidang militer adalah pada pengatur lalu lintas udara atau yang dikenal dengan Air Traffic Controllers (ATC) yang dipakai oleh para pilot untuk mendapatkan keterangan mengenai keadaan lalu-lintas udara seperti radar, cuaca, dan navigasi. Alat pengenal ucapan digunakan sebagai pengganti operator yang memberikan informasi kepada pilot dengan cara berdialog.
- Helikopter : Aplikasi alat pengenal ucapan pada helikopter digunakan untuk berkomunikasi lewat radio dan menyesuaikan sistem navigasi. Alat ini sangat diperlukan pada helikopter karena ketika terbang, sangat banyak gangguan yang akan menyulitkan pilot bila harus berkomunikasi dan menyesuaikan navigasi dengan terlebih dahulu memencet tombol tertentu.
- Lain-Lain : Teknologi ini digunakan pada pengoperasian berbagai peralatan pesawat tempur seperti penentuan frekuensi radio, pengaktifan sistem autopilot, penentuan koordinat tuas kendali, parameter peluncuran senjata, pengaktifan sistem navigasi, dan pengaturan tampilan status penerbangan.

- Entertainment
- Pada beberapa games komputer,voice recognition digunakan untuk menyelesaikan misi-misi tertentu seperti pada game Tom Clancy’s End war dan LIfeline. Selain itu teknologi ini juga dapat digunakan untuk membantu proses pengetikan pada orang yang memiliki cacat pada bagian tangan.
- Beberapa software yang menggunakan sistem teknologi speech recognition antara lain Microsoft Voice Command, Nuance Voice Control, VITO Voice2Go, Speereo Voice translator dan SVOX.

Contoh Implementasi teknologi Speech Recognition :
Saat ini pada tahun 2010
Microsoft windows vista dan windows 7 , speech recognition telah disertakan
dalam system operasinya . sebagaimana fungsi dari speech recognition
menterjemahkan pengucapan kata – kata kedalam bentuk teks digital. Salah
satu implementasi speech recognition adalah pada konfrensi PBB dimana seluruh
Negara tergabung dalam keanggotaan nya , fungsi speech recognition dalam hal
ini menterjemahkan bahasa pembicara dari suatu Negara kedalam bahasa yang
dipahami pendengar . Contoh penggunaan lain speech recognition adalah Perawatan
kesehatan.
Dalam perawatan kesehatan domain,
bahkan di bangun meningkatkan teknologi pengenalan suara, transcriptionists
medis (MTs) belum menjadi usang. Layanan yang diberikan dapat didistribusikan
daripada diganti. Pengenalan pembicaraan dapat diimplementasikan di
front-end atau back-end dari proses dokumentasi medis. Front-End SR adalah
salah satu alat untuk mengidentifikasi kata-kata yang ucapkan dan ditampilkan
tepat setelah mereka berbicara Back-End SR atau SR tangguhan adalah di mana
penyedia menentukan menjadi sebuah sistem dikte digital, dan suara yang
diarahkan melalui pidato-mesin pengakuan dan draft dokumen diakui dirutekan
bersama dengan file suara yang asli ke MT / editor, yang mengedit draft dan
memfinalisasi laporan. Ditangguhkan SR sedang banyak digunakan dalam industri
saat ini.
Banyak aplikasi Electronic
Medical Records (EMR) dapat menjadi lebih efektif dan dapat dilakukan lebih
mudah bila digunakan dalam hubungannya dengan pengenalan-mesin bicara. Pencarian,
query, dan pengisian formulir semua bisa lebih cepat untuk melakukan dengan
suara dibandingkan dengan menggunakan keyboard.

Kelebihan
Kelebihan dari peralatan yang menggunakan
teknologi ini adalah :
- Cepat
- Teknologi ini mempercepat transmisi informasi dan umpan balik dari transmisi tersebut. Contohnya pada komando suara. Hanya dalam selang waktu sekitar satu atau dua detik setelah kita mengkomandokan perintah melalui suara, komputer sudah memberi umpan balik atas komando kita.
- Mudah digunakan
- Kemudahan teknologi ini juga dapat dilihat dalam aplikasi komando suara. Komando yang biasanya kita masukkan ke dalam komputer dengan menggunakan tetikus atau papan ketik kini dapat dengan mudahnya kita lakukan tanpa perangkat keras, yakni dengan komando suara.

Kekurangan
Kekurangan dari peralatan yang
menggunakan teknologi ini adalah :
- Rawan terhadap gangguan
- Hal ini disebabkan oleh proses sinyal suara yang masih berbasis frekuensi. Ketika sebuah informasi dalam sinyal suara mempunyai komponen frekuensi yang sama banyaknya dengan komponen frekuensi gangguannya, akan sulit untuk memisahkan gangguan dari sinyal suara
- Jumlah kata yang dapat dikenal terbatas
- Hal ini disebabkan pengenal ucapan bekerja dengan cara mencari kemiripan dengan basis data yang dimiliki.

Kesimpulan:
Suatu pengembangan sistem yang
memungkinkan komputer untuk menerima masukan berupa kata yang diucapkan. Alat
pengenal ucapan atau yang sering disebut dengan Speech Recognizer, membutuhkan
sampel kata sebenarnya yang diucapkan dari pengguna. Penggunaan speech recognicition telah berkembang di berbagai sistem device seperti pada OS Windows dengan Speech Recognition, smartphone Android, dan yang paling terkenal adalah aplikasi Siri pada iPhone.
Sumber:
Subscribe to:
Posts
(Atom)
UNIVERSITAS GUNADARMA

CLOCK

